
Los ecosistemas de datos son la base para que una pyme pueda usar IA de forma fiable: conectan ventas, CRM, facturación, atención al cliente, operaciones y documentos internos bajo reglas comunes de calidad, seguridad y acceso. Sin esa base, los modelos responden con información incompleta, duplicada o desactualizada, y la automatización acaba generando más revisión manual que ahorro real.
Qué son los ecosistemas de datos y por qué importan para la IA
Un ecosistema de datos no es solo un almacén central. Es el conjunto de fuentes, procesos, permisos, responsables, herramientas y controles que permiten convertir datos dispersos en información útil para personas, cuadros de mando, automatizaciones y modelos de inteligencia artificial.
La diferencia frente a “tener muchos datos” está en la conexión y en la gobernanza. Una empresa puede tener hojas de cálculo, ERP, CRM, tickets, correos, documentos y bases SQL, pero si cada área nombra los campos de forma distinta, guarda versiones contradictorias o no documenta el origen, la IA no tendrá contexto fiable.
Para escalar IA, el objetivo no es entrenar un modelo enorme desde el primer día. El objetivo es que cada caso de uso pueda acceder a datos correctos, trazables, actualizados y autorizados. Esto aplica tanto a un chatbot interno como a un sistema de previsión de demanda, un asistente comercial o un flujo de automatización en atención al cliente.
| Modelo de trabajo | Qué ocurre en la práctica | Impacto en IA |
|---|---|---|
| Datos aislados | Cada departamento guarda su propia versión de clientes, productos, incidencias o ventas. | La IA responde con inconsistencias, mezcla fuentes y exige mucha supervisión humana. |
| Datos conectados sin gobierno | Las herramientas se integran, pero no hay responsables, catálogo, permisos ni control de calidad. | La automatización mejora, pero aumenta el riesgo de errores, fugas y decisiones opacas. |
| Ecosistema de datos gobernado | Fuentes, reglas, accesos, métricas y documentación se gestionan como un activo empresarial. | La IA puede escalar con más seguridad, trazabilidad y reutilización entre procesos. |
En proyectos de IA generativa, esta base cobra más importancia porque los modelos no “saben” qué dato interno es válido si la empresa no se lo indica. Por eso conviene combinar integración, recuperación documental, permisos por rol y evaluación continua. Si estás empezando, merece la pena revisar antes una guía práctica para implementar IA en una empresa y priorizar los casos de uso con retorno medible.

Arquitectura mínima para IA escalable
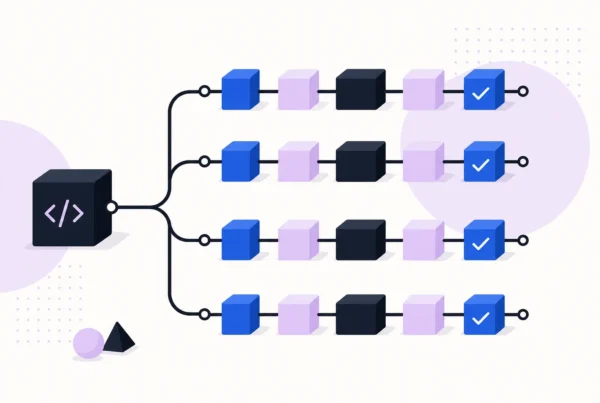
Una arquitectura útil para pymes debe ser sencilla de operar y suficientemente robusta para crecer. No hace falta copiar la infraestructura de una gran tecnológica. Hace falta diseñar un flujo claro: capturar datos, limpiarlos, almacenarlos, documentarlos, protegerlos y servirlos a aplicaciones de IA.
1. Fuentes bien identificadas
El primer inventario debe incluir CRM, ERP, facturación, ecommerce, formularios web, campañas, call center, tickets, documentos internos y bases operativas. Cada fuente necesita un propietario funcional, una frecuencia de actualización y una clasificación básica: datos personales, datos sensibles, datos financieros, datos contractuales o datos públicos.
- CRM: clientes, oportunidades, histórico comercial, comunicaciones y estado de cada cuenta.
- ERP o facturación: pedidos, albaranes, márgenes, pagos, inventario y proveedores.
- Soporte: incidencias, tiempos de respuesta, motivos de contacto y satisfacción.
- Documentación: manuales, políticas, ofertas, contratos, procedimientos y conocimiento interno.
2. Capa de integración
La capa de integración evita copiar y pegar datos entre sistemas. Puede hacerse con conectores nativos, APIs, herramientas ETL/ELT, automatizaciones no-code o flujos propios. Lo importante es que cada movimiento quede registrado: origen, transformación aplicada, fecha, usuario o servicio responsable y destino.
Para una pyme española, una buena regla es empezar por integraciones de alto impacto: clientes, ventas, productos, facturas y tickets. Después se añaden documentos, conversaciones y datos externos. Si se intenta conectar todo a la vez, el proyecto se vuelve caro y difícil de mantener.
3. Almacenamiento y capa semántica
El almacenamiento puede ser una base relacional, un data warehouse, un lakehouse o una combinación ligera según el volumen y la complejidad. Más importante que el nombre de la tecnología es definir una capa semántica: qué significa “cliente activo”, “venta neta”, “margen”, “lead cualificado” o “incidencia crítica”.
Sin esa capa, cada informe y cada agente de IA calcularán los indicadores de forma distinta. Con ella, los modelos pueden responder usando definiciones compartidas por dirección, ventas, finanzas y operaciones.
4. Búsqueda, RAG y agentes
Para IA generativa, muchas pymes no necesitan reentrenar modelos. Les basta con un sistema de recuperación aumentada por generación, conocido como RAG, que busca información en documentos internos y la entrega al modelo con instrucciones y límites claros. Si el caso requiere acción, se puede evolucionar hacia agentes que consulten datos, creen tareas o ejecuten flujos bajo permisos.
La clave es no dar acceso total a un agente desde el primer día. Empieza con lectura, trazabilidad y revisión humana. Después habilita escritura o ejecución solo en procesos acotados. Para profundizar, puedes ver cómo funciona un enfoque de Agentic RAG para pymes bajo control.
Gobernanza, seguridad y cumplimiento en España y la UE
La parte técnica no sirve si la empresa no sabe quién decide sobre los datos. La gobernanza define propietarios, permisos, políticas de conservación, calidad mínima, trazabilidad y criterios de uso en IA. También evita que cualquier empleado suba información sensible a herramientas externas sin control.
Desde el 12 de septiembre de 2025 es aplicable la Ley de Datos de la UE, que busca facilitar el acceso y uso de datos, especialmente los generados por productos conectados, y refuerza la interoperabilidad y el mercado europeo de datos según la Comisión Europea. Para pymes con maquinaria, dispositivos IoT, vehículos, sensores o servicios conectados, esto afecta a contratos, acceso a datos y estrategia de reutilización. Ver explicación de la Ley de Datos de la Comisión Europea.
El Reglamento Europeo de Inteligencia Artificial entró en vigor el 1 de agosto de 2024 y, según el calendario oficial, su aplicación general comenzó el 2 de agosto de 2026, con excepciones previas como prácticas prohibidas y alfabetización en IA desde el 2 de febrero de 2025. En la práctica, las empresas deben documentar mejor sus usos, riesgos, proveedores, datos utilizados y supervisión humana. Consultar calendario oficial del Reglamento de IA.
En datos personales, el RGPD sigue siendo el marco central. La AEPD recuerda que la protección de datos desde el diseño exige incorporar garantías durante todo el ciclo de vida del tratamiento, no solo al final del desarrollo. Esto encaja directamente con los ecosistemas de datos: minimización, acceso por rol, plazos de conservación y evaluación de riesgos deben diseñarse antes de conectar fuentes a sistemas de IA. Ver orientación de la AEPD sobre protección de datos desde el diseño.
- Propietario del dato: persona responsable de calidad, definición y uso permitido de cada conjunto de datos.
- Catálogo: inventario consultable de fuentes, campos, sensibilidad, origen y frecuencia de actualización.
- Control de acceso: permisos por rol, principio de mínimo privilegio y revisión periódica de usuarios.
- Trazabilidad: registro de cambios, consultas, automatizaciones y respuestas críticas generadas por IA.
- Evaluación de riesgos: análisis previo de impacto legal, operativo, reputacional y de protección de datos.
Como marco de gestión, ISO/IEC 42001:2023 define un sistema de gestión para organizaciones que desarrollan, proporcionan o usan sistemas de IA. No sustituye al RGPD ni al Reglamento de IA, pero ayuda a ordenar políticas, responsabilidades, objetivos, controles y mejora continua. Ver norma ISO/IEC 42001.
Hoja de ruta práctica para pymes españolas
La mejor forma de construir un ecosistema de datos no es comprar una plataforma enorme. Es elegir un proceso con impacto, medir el coste actual del problema y crear una base reutilizable. Estos son los pasos que aplicaría en una pyme con recursos limitados.
Fase 1: diagnóstico de datos y casos de uso
Haz un mapa de procesos donde la IA pueda ahorrar tiempo o mejorar decisiones: ventas, atención al cliente, compras, producción, administración o marketing. Después identifica qué datos necesita cada caso, dónde están, quién los usa y qué problemas tienen: duplicados, campos vacíos, formatos distintos, falta de permisos o ausencia de histórico.
- Pregunta clave: ¿qué decisión o tarea queremos mejorar con IA?
- Salida esperada: inventario inicial de fuentes, responsables y riesgos.
- Error típico: empezar por la herramienta antes de saber qué dato alimentará el sistema.
Fase 2: limpieza y modelo común
Antes de automatizar, hay que normalizar lo básico: nombres de clientes, códigos de producto, estados comerciales, categorías de incidencias y criterios de facturación. No hace falta resolver toda la empresa. Elige los datos mínimos del primer caso de uso y documenta las reglas.
Si el primer proyecto es un asistente para ventas, céntrate en CRM, catálogo, tarifas, histórico de oportunidades y argumentarios. Si es atención al cliente, prioriza tickets, base de conocimiento, pedidos y políticas de devolución. Si es dirección, trabaja sobre métricas financieras y operativas.
Fase 3: piloto con IA y control humano
El piloto debe tener un alcance cerrado, usuarios concretos y métricas desde el inicio. Por ejemplo: reducir el tiempo de preparación de propuestas, clasificar tickets, responder preguntas internas sobre procedimientos o generar resúmenes de reuniones comerciales.
Durante esta fase conviene guardar preguntas, respuestas, fuentes utilizadas y correcciones humanas. Ese registro permite detectar alucinaciones, documentos mal indexados, permisos excesivos o instrucciones ambiguas. Si vas a crear asistentes sobre documentación interna, esta guía sobre IA personalizada con tus propios datos usando NotebookLM te puede servir como punto de partida.
Fase 4: escalado y automatización
Cuando el piloto funciona, se convierte en servicio interno: permisos, mantenimiento, responsables, formación, soporte y revisión periódica. A partir de ahí se conectan nuevos procesos y se automatizan acciones de bajo riesgo. El escalado no consiste en abrir la IA a todos, sino en repetir un patrón controlado.
- Tiempo ahorrado: horas mensuales reducidas por tarea o departamento.
- Calidad: porcentaje de respuestas aceptadas sin corrección relevante.
- Riesgo: número de errores críticos, accesos indebidos o respuestas sin fuente.
- Adopción: usuarios activos, frecuencia de uso y procesos cubiertos.
- Retorno: ahorro, ingresos recuperados, reducción de incidencias o mejora de conversión.
Para justificar inversión, no presentes la IA como moda. Preséntala como mejora operativa. Calcula coste actual, coste de implantación, ahorro esperado y riesgos mitigados. Aquí encaja una lectura complementaria sobre cómo medir el ROI de la IA en una pyme.
Errores comunes y cómo evitarlos
El error más frecuente es confundir integración con estrategia. Conectar aplicaciones sin definir calidad, permisos y responsables solo mueve el desorden de un sitio a otro. La IA hará visibles esos problemas porque responderá con datos contradictorios o incompletos.
- No tener dueño del dato: cada campo crítico necesita una persona o área responsable. Sin propietario, nadie corrige errores ni valida cambios.
- Usar datos personales sin base clara: antes de alimentar una IA, revisa finalidad, legitimación, minimización, conservación y acceso.
- Indexar documentos obsoletos: un asistente documental solo es útil si distingue versiones vigentes de borradores antiguos.
- No medir calidad: define métricas simples: duplicados, campos vacíos, frescura del dato, errores detectados y respuestas corregidas.
- Automatizar demasiado pronto: primero lectura y recomendación; después acciones con aprobación; finalmente automatización controlada.
- Depender de una sola herramienta: diseña los datos para poder cambiar de proveedor si lo necesitas. La portabilidad importa.
También conviene separar tres capas: datos maestros, documentos y eventos. Los datos maestros describen entidades estables como clientes, productos o proveedores. Los documentos contienen conocimiento no estructurado. Los eventos registran actividad: compras, llamadas, tickets, clics o entregas. Mezclarlos sin criterio complica la búsqueda y empeora las respuestas.
El NIST AI Risk Management Framework para IA generativa insiste en gestionar riesgos específicos de estos sistemas, como documentación, evaluación, monitorización y controles proporcionales al uso. No es una obligación europea, pero sí una referencia práctica para ordenar riesgos técnicos y organizativos cuando se despliegan soluciones de IA generativa. Ver perfil de IA generativa del NIST AI RMF.
Mi recomendación para pymes: no busques el ecosistema perfecto. Construye una base mínima, gobernada y ampliable. Si el dato crítico está limpio, documentado y protegido, la IA puede aportar valor. Si no lo está, cada nuevo asistente será una capa más sobre un problema antiguo.
Preguntas frecuentes
¿Qué diferencia hay entre un ecosistema de datos y un data warehouse?
Un data warehouse es una pieza de almacenamiento y análisis. Un ecosistema de datos incluye además fuentes, integraciones, calidad, catálogo, seguridad, responsables, políticas, permisos y usos de negocio. Para IA, esta diferencia es importante porque el modelo no solo necesita datos guardados: necesita contexto, definiciones comunes, trazabilidad y acceso controlado.
¿Una pyme necesita un ecosistema de datos para usar IA?
Sí, aunque no tiene que empezar con una arquitectura compleja. Una pyme puede crear un ecosistema mínimo conectando CRM, facturación, documentos y soporte bajo reglas claras. Lo importante es que los datos usados por la IA estén actualizados, sean fiables y tengan permisos adecuados. Si no, el ahorro prometido se pierde revisando errores.
¿Qué datos debería conectar primero una empresa pequeña?
Empieza por los datos que desbloqueen un caso de uso rentable. En ventas: CRM, tarifas, catálogo e histórico de oportunidades. En soporte: tickets, pedidos y base de conocimiento. En administración: facturas, proveedores y vencimientos. Evita conectar fuentes “por si acaso”; cada dato añadido aumenta mantenimiento, riesgo y complejidad.
¿Cómo se evita que la IA use información confidencial?
La prevención combina permisos por rol, clasificación de datos, registros de acceso, anonimización cuando proceda y revisión humana en procesos sensibles. También debes limitar qué fuentes consulta cada asistente y evitar cargas manuales de documentos confidenciales en herramientas no autorizadas. La seguridad debe diseñarse antes del piloto, no después del primer incidente.
¿Cuándo merece la pena automatizar con agentes de IA?
Merece la pena cuando el proceso está bien definido, los datos son fiables y el riesgo de error está controlado. Primero usa la IA para consultar, resumir o recomendar. Después permite acciones con aprobación humana. Solo automatiza de punta a punta tareas repetitivas, medibles y reversibles, como clasificaciones, avisos, borradores o actualizaciones simples.
Fuentes
- Comisión Europea: explicación de la Ley de Datos
- AI Act Service Desk: calendario de aplicación del Reglamento Europeo de IA
- AEPD: protección de datos desde el diseño
- AEPD: protección de datos por defecto
- NIST: AI Risk Management Framework, perfil para IA generativa
- ISO: ISO/IEC 42001:2023, sistemas de gestión de IA
¿Quieres aplicar esto en tu empresa?
Somos una consultoría de IA y automatización especializada en la industria. Cuéntanos qué tarea os quita más horas y te decimos, sin compromiso, qué se puede automatizar y cuánto costaría.